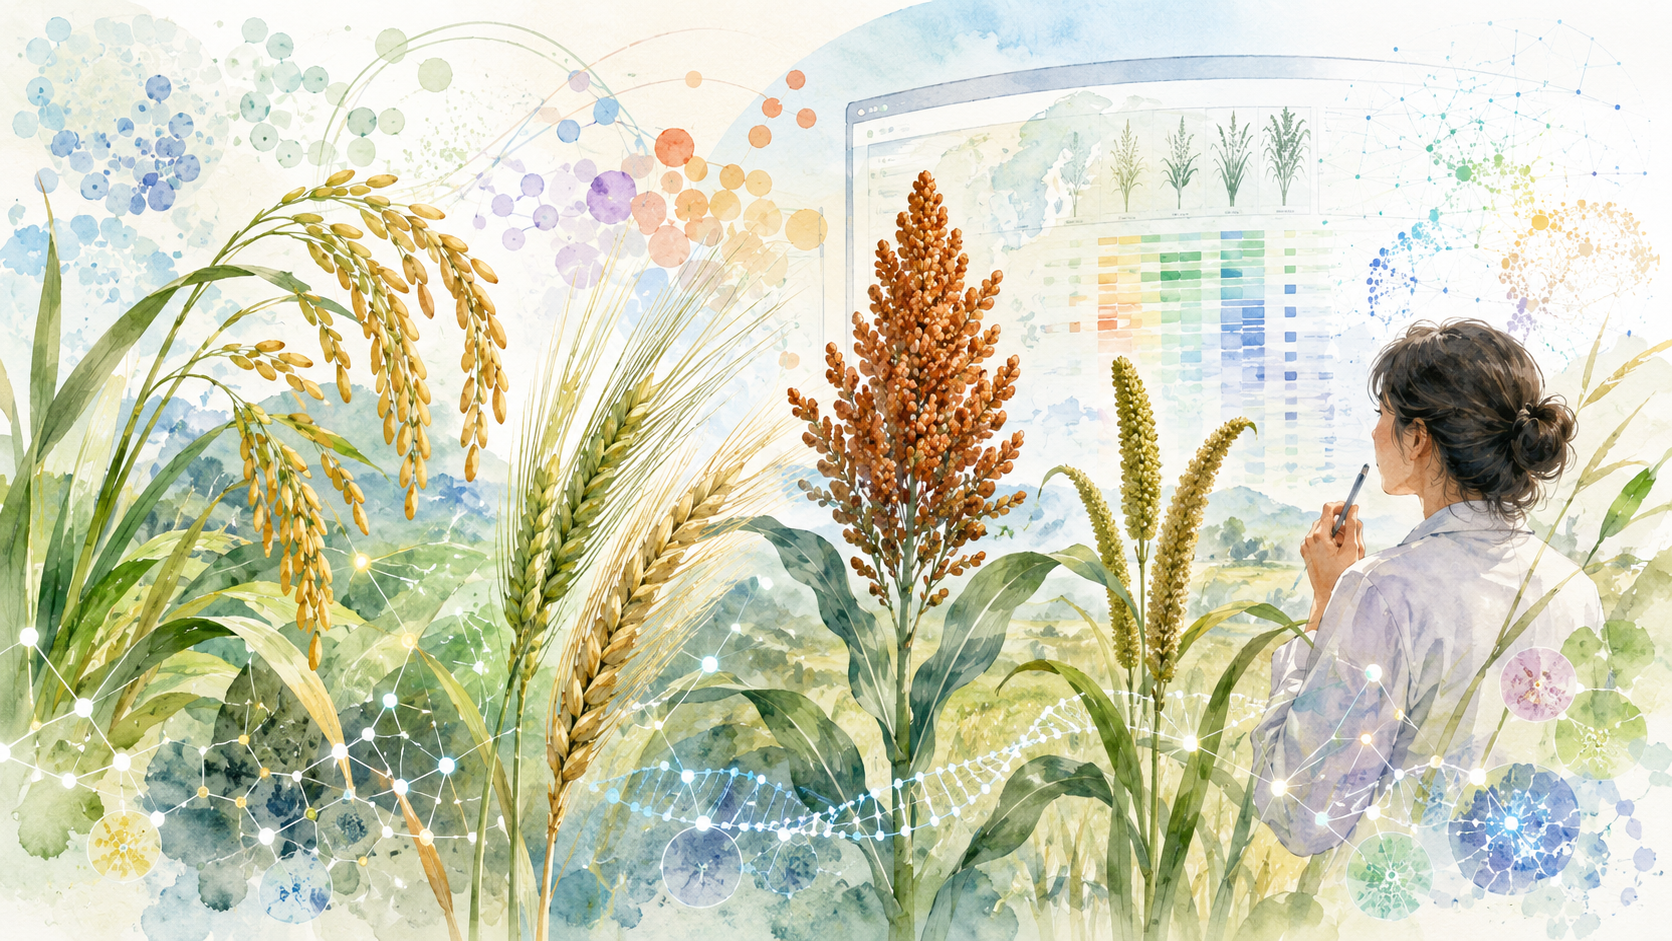
RNA-seqで遺伝子発現を調べることは、植物研究では日常的な手法になりました。組織、発生段階、ストレス処理、変異体と野生型――世界中で大量のRNA-seqデータが生産され、SRAなどの公共リポジトリに蓄積されています。
しかし、FASTQファイルが公開されていることと、そのデータをすぐ研究に使えることは同じではありません。どの組織なのか、どんな処理をしたのか、どの品種なのかを確認し、データを取得し、QC、mapping、count、normalizationまで進める必要があります。
2026年9月2日、『Plant and Cell Physiology』にDatabase Paperのaccepted manuscriptとして公開されたGrass Expression Atlas(GExA)は、この障壁をイネ科、とくにmillet類で下げようとする研究インフラです。
このresourceが示しているのは、RNA-seqを新しく「取る」ことだけではなく、世界中にすでに存在するRNA-seqを掘り直して研究資産に変えるという研究workflowです。
4,753のpublic RNA-seqを「検索できるデータ」へ
現在のGExAには、pearl millet、foxtail millet、proso millet、finger millet、sorghum、barley、riceの7種が収録されています。合計は4,753 samples、457 BioProjectsです。
とくに大きいのはfoxtail milletの2,216 samplesとpearl milletの987 samplesです。一方、riceは80 samplesです。現行版にはコムギとトウモロコシは含まれていません。
そのため、名前だけを見ると「イネ科全般を広くカバーしたatlas」に見えますが、現時点での特徴はむしろ、millet類のpublic transcriptomeをまとまった形で探索できることにあります。
GExAは、公開RNA-seqを単に集めたリンク集ではありません。raw readsを統一したworkflowで処理し、gene-level read countとTPMを作成し、さらにtissue、treatment、developmental stage、cultivarなどのmetadataを整理しています。
つまり、
SRA accessionの集合
を、
「どこで、いつ、どんな条件で、この遺伝子が発現していたのか」を検索できるデータ
へ変換しています。
ここがGExAの本体です。
「この遺伝子、何をしていそう?」から始められる
GExAではGene IDを入力すると、その遺伝子の発現をtissue、treatment、developmental stage、cultivarなどでグループ化して確認できます。複数遺伝子をまとめて表示することもできます。
さらにGene IDが分からなくても、riceやArabidopsisのタンパク質とのBLASTP homology annotationを利用し、annotation keywordから候補遺伝子を探せます。各sampleのmetadataも確認でき、元のBioProjectへ戻ることができます。
公式Helpでは、pearl milletのdpca1g022930.840が例として使われています。これはrice HVA22に近いhomologで、HVA22はdehydrationやABA応答との関連が知られています。GExA上でもdroughtやABAに関連する複数のsampleを探索できます。
重要なのは、ここで「この遺伝子は乾燥耐性遺伝子だ」と結論することではありません。
面白そうな条件を見つけ、元のexperimentへ戻ることです。
RNA-seqを取る前の一次探索に使う
たとえば、ある遺伝子が乾燥耐性に関係するのではないかと考えたとします。
これまでは関連論文を検索し、Supplementary dataを探し、必要ならSRAからRNA-seqを取得して再解析する必要がありました。
GExAがあれば、その前に、
- rootで発現しているか
- drought条件で高いsampleがあるか
- reproductive tissueでも強く発現していないか
- 特定cultivarだけに偏っていないか
といったことを短時間で確認できます。
そこで興味深いpatternが見つかったら、そのsampleが属するBioProjectや原論文へ戻り、実験条件を確認する。必要ならraw dataを取得して自分で解析する。
研究workflowとしては、
Atlasで探索する → 元BioProject・原論文を確認する → 必要なら本解析する
という順番です。
GExAは結論を出すためのtoolというより、次に何を見るべきかを決めるtoolと考えると分かりやすいでしょう。
4,753 samplesは「4,753 biological replicates」ではない
ただし、GExAを使ううえで非常に重要な注意点があります。
4,753 samplesは一つの巨大な実験から得られたものではなく、457の異なるBioProjectsから集められています。
研究室、栽培条件、RNA抽出、library preparation、sequencing platform、read length、experimental designなどが異なります。同じworkflowで再解析してTPMへ揃えても、こうしたbatch effectやconfoundingが消えるわけではありません。
著者らもこの限界を明確に述べています。GExAは主としてexploratory analysisとhypothesis generationに使うresourceであり、厳密なdifferential expressionやcausal interpretationには、適切にcontrolされた独立データによる検証が必要です。
たとえば、異なるBioProjectのsampleを見て、
「droughtのTPMがcontrolの5倍だから、この遺伝子は乾燥で5倍誘導される」
と単純に断定することはできません。
一方で、
「複数のdrought関連datasetで高発現が見える」
「root由来sampleに偏ったpatternがある」
といったsignalを見つけ、次の仮説を作るためには使えます。
証明ではなく探索。
この距離感が、public RNA-seqを再利用するうえでは重要です。
speciesをまたいだ「直接比較tool」ではない
もう一つ注意したいのは、GExAをcross-species expression comparison platformと呼ぶのは少し強すぎることです。
複数のgrass speciesが同じresourceに収録され、riceやArabidopsisとのhomology annotationを手掛かりに相同遺伝子を探すことはできます。しかし現行UIは、orthologを自動的に対応付け、species間で発現量を統計的に直接比較することを主目的としたsystemではありません。
したがって、GExAのcross-speciesな価値は、まず複数speciesで相同遺伝子と発現情報を横断的に探索しやすくすることにあります。
本格的なspecies間比較には、orthology、組織対応、発生段階、normalizationなどを別途考える必要があります。
reference genomeが変われば、見えるexpressionも変わり得る
GExAで少し技術的に面白いのがpearl milletです。
pearl milletにはTift、ICMB843、ICMR06777という3つのreference genomeが用意されています。
RNA-seqではsampleとreference genomeのsequence divergenceが大きくなるとmapping efficiencyが変化し、expression estimateにも影響する可能性があります。つまり発現が低く見えたとき、それが本当に低発現なのか、referenceとの配列差によってreadがmapされにくかったのかを考える必要があります。
GExAではpearl milletについて複数referenceの結果を確認でき、別cultivarのhigh-similarity geneへ移動する機能も用意されています。
public RNA-seqは「同じFASTQを使えば同じ答えになる」わけではありません。
reference genomeも解析条件の一部です。
GExAのmulti-reference設計は、その問題をかなり具体的に見せています。
RNA-seq再利用という発想自体は新しくない
ここはGExAを過大評価しないために重要です。
public transcriptomeを集約・再解析して検索可能にする試みは以前からあります。
EMBL-EBIのExpression Atlasは長年運用されており、多数のspeciesとstudyを横断してgene expressionを検索できます。
植物に特化したPlantExpも、2023年の報告時点で85 plant species、131,423 public RNA-seq samplesを統一処理し、expression、differential expression、co-expression、alternative splicing、cross-species expression conservationなどを提供しています。
つまりGExAは、public RNA-seq reuseを初めて考えたresourceでも、最大のplant expression databaseでもありません。
では何が重要なのでしょうか。
私はむしろ、この研究インフラがmillet類まで降りてきたことに意味があると考えます。
主要モデル植物や主要作物だけでなく、これまでbioinformatics infrastructureが相対的に薄かった作物でも、公開RNA-seqを「見つける」だけでなく「すぐ探索する」環境が作られ始めています。
巨大な汎用databaseと競争するというより、まだ使いにくい作物のpublic dataを研究資産へ変える。GExAはそういうresourceです。
新しいRNA-seqを取る前に、まず既存データを見る
もちろん、これから新しいRNA-seqが不要になるわけではありません。
厳密なcontrol、目的に合ったtissue、genotype、developmental stage、sampling timeを揃えて仮説を検証するには、新しい実験が必要です。
しかし、その前段階は変えられます。
候補遺伝子を見つけた。
すぐRNA-seqを設計するのではなく、まず既存のpublic RNA-seqを見る。
そこで仮説を絞り、不足している条件を確認する。
そして、既存データでは答えられない問いに対して新しいRNA-seqを取る。
この順番なら、新しく取得するRNA-seqの価値もむしろ高くなります。
RNA-seqを大量に「生産する」時代から、
すでに蓄積されたRNA-seqを探索し、再利用し、そのうえで本当に必要なデータを新しく生産する時代へ。
GExAは、その変化をgrass research、とくにmillet研究で具体的に見せているresourceだと思います。
「データを公開する」の次は、「使える状態にする」
public repositoryにFASTQをdepositすることは、いまでは研究の標準的な手続きです。
しかし、データが公開されているだけでは、再利用のハードルは依然として高いままです。
metadataを整理し、統一したpipelineで再解析し、Gene IDやannotationから検索でき、元のexperimentまで戻れるようにして初めて、「過去のRNA-seq」が次の研究仮説に参加できます。
GExAが作ったのは新しいRNA-seq datasetというより、
すでに存在していたRNA-seqと、次の研究仮説の間をつなぐ層
だと見ることができます。
さらに同じ研究グループは2026年8月、GExAのデータをbuilt-inで利用でき、browser内でdifferential expression analysisを行うDEAR-OWLをpreprintとして公開しています。まだ査読前ですが、atlasが「見るためのdatabase」から「公開データをその場で再解析する環境」へ発展する方向も見えてきました。
研究データの価値は、取得した瞬間だけにあるわけではありません。
何年も前に別の研究者が取得したRNA-seqが、新しい候補遺伝子を評価し、実験設計を変え、新しい仮説につながることがあります。
そのために必要なのは、さらに多くのデータを作ることだけではなく、すでにあるデータを使えるKnowledgeへ変換するインフラです。
Grass Expression Atlasは派手な生物学的発見を報告する論文ではありません。
しかし、「次のRNA-seqを取る前に、まず過去のRNA-seqを調べる」というworkflowが標準になっていくなら、この種のdatabase paperの意味はかなり大きいのではないでしょうか。
参考資料
- Kambara K, Chen Q, Tsugama D. Grass Expression Atlas: an RNA-seq-based expression resource for grass species. Plant and Cell Physiology. 2026. DOI: 10.1093/pcp/pcag122. https://academic.oup.com/pcp/advance-article/doi/10.1093/pcp/pcag122/8780316
- Grass Expression Atlas: https://www.gexa.anesc.u-tokyo.ac.jp/
- GExA About: https://www.gexa.anesc.u-tokyo.ac.jp/About/index.html
- GExA Help: https://www.gexa.anesc.u-tokyo.ac.jp/Help/index.html
- GExA Download: https://www.gexa.anesc.u-tokyo.ac.jp/Download/index.html
- Ma S, et al. PlantExp: a platform for exploration of gene expression and alternative splicing profiles in 85 plant species. Nucleic Acids Research (2023). https://academic.oup.com/nar/article/51/D1/D1483/6769746
- Expression Atlas update: https://pmc.ncbi.nlm.nih.gov/articles/PMC12807774/
- DEAR-OWL preprint: https://www.biorxiv.org/content/10.64898/2026.07.28.741369v1
コメント